大模型迭代不断提速,国产GPU适配如何不再“慢半拍”?
过去两年,大模型以近乎“月更”的速度狂飙突进。新架构、新参数规模、新推理特性层出不穷,今天刚跑通一个版本,明天又来了一个新模型。
接入一款新模型,从来不是“下载权重、跑起来”这么简单。它往往意味着一整套复杂流程:框架适配、精度对齐、性能调优……每一步都要反复调试,每一步都依赖资深专家。模型跑得快,适配却常常慢半拍,成了AI规模化落地中一道绕不过去的坎。
不同硬件架构、不同软件栈、不同算子实现,让迁移适配变成了一场耗时耗力的“手工活”。专家人力有限,周期漫长,项目等不起,业务也等不起。
一个新模型要适配一款新芯片,传统上意味着数周甚至数月的拉通、优化、反复调试,背后是一支资深工程师团队的持续投入。模型迭代越来越快,适配却始终是慢变量——这一慢,就慢成了智算落地最深的瓶颈。
问题出在哪?从模型到硬件之间,缺一条自动化的“适配流水线”。
过去,这条流水线是靠人堆出来的:一个人负责量化,一个人负责框架,一个人调算子,一个人做精度验证,一个人盯性能……每个环节都要专家,每个环节都可能卡住。一旦模型更新,所有工作又要重来一遍。这种"手工作坊"式的适配方式,注定追不上大模型高频迭代的节奏。
能否让“AI自己搞定适配AI的事”?
中兴通讯给出的答案是:ModelGenius——一个以AI智能体为核心、面向新模型全流程适配与性能优化的智能化平台。不跟模型赛跑,而是让AI替人类去追赶模型迭代。它不是把某个环节的工具做成自动化脚本,而是让整个“模型迁移”的过程,第一次有了“自我组织、自我执行、自我进化”的能力。
极速迁移:把"人海战术"变成“AI自动化”
新模型适配从来不是“跑通就完”的单一动作,而是一条从模型结构分析、框架适配、服务部署、精度验证到性能优化的完整链路。传统方式下,每个环节都依赖专业工程师手工介入、反复迭代,整体交付周期往往以周乃至月计。
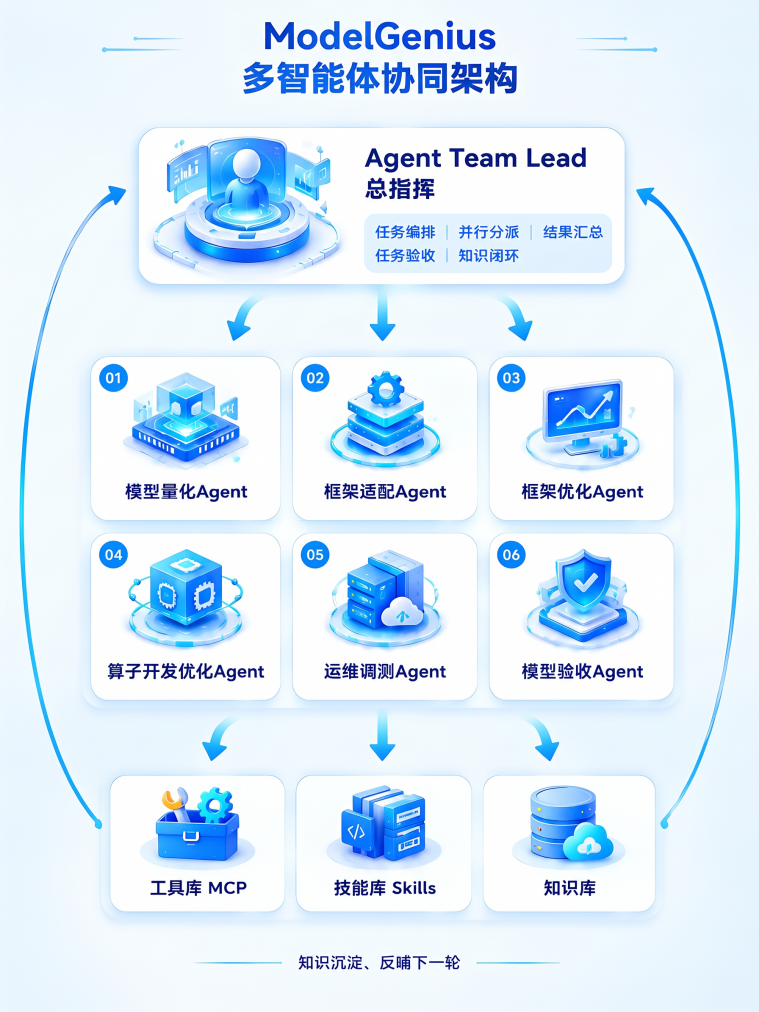
ModelGenius将这条链路交给多个专业AI智能体协同完成。在这个系统里,有一个“总指挥”"——Agent Team Lead(总指挥),负责任务编排、并行分派、结果汇总、任务验收和知识闭环。它接到用户需求后,会先分析模型、设计方案,然后把任务拆解下发给六大专业Agent:
·模型量化Agent:负责量化策略分析、框架量化适配、精度性能验证;
·框架适配Agent:负责框架升级、算子接入、服务拉通;
·框架优化Agent:负责MTP、PD分离、投机推理、多级缓存等高级优化;
·算子开发优化Agent:负责算子的设计、开发、优化与验证;
·运维调测Agent:负责异常诊断、精度定位与性能分析;
·模型验收Agent:负责精度验证、性能验证与验收报告。
本质上,这是把一支顶级适配工程师团队装进了系统里。六大Agent各司其职,又彼此协同,配合统一的任务编排、门控校验与异常自愈机制,形成“需求拆解→方案设计→并行执行→自动验收→复盘沉淀”的闭环;验收不通过即自动回滚重来,直到达标为止。工程师从“亲力亲为”转向“监督把关”,人力投入大幅下降。
从架构上看,ModelGenius采用“Agent Team Lead + 专业Agent”的多智能体协同模式:顶层是任务编排与验收中枢,中层是六大专业Agent,底层则由工具库MCP、技能库Skills和知识库三层支撑。三者之间形成双向闭环——每一次任务执行都会沉淀为新的Skill与知识,反哺下一轮适配。
这不是一份纸面规划,而是一张写满实战成绩的适配记录单:中兴通讯ModelGenius已完成多款热门大模型的端到端适配验证,覆盖主流国产GPU平台。其中,Qwen3.5-27B仅用1天即完成框架拉通与精度对齐,MiMo-V2.6-Flash-RL用时2天,Step-3.7-Flash用时3天;DeepSeek-V4-Flash、GLM-5.2等均在一周内完成从框架接入到性能调优的全流程交付。模型推理吞吐较初始手工配置基线提升数十倍。
极致性能:软硬协同深调优,释放超节点红利
如果说ModelGenius解决的是“能不能快速跑起来”,那么它与OEX超节点的软硬协同,解决的则是“能不能跑出最佳性价比”。
OEX超节点的核心优势,在于通过开放的高速互联协议与交换芯片构建高带宽域(High-Bandwidth Domain),将数十至数百颗GPU在逻辑上整合为统一编址、低延迟、高带宽的协同计算系统。但硬件红利不会自动兑现,需软件侧针对每个模型“量体裁衣”,才能把带宽与内存优势转化为实际的吞吐、时延与成本优势。
这正是ModelGenius的用武之地。面对超节点的高带宽与统一内存访问特性,ModelGenius可针对每个模型做“自适应迭代自优化”:并行策略如何切分、张量并行与专家并行怎样跨卡展开、KV Cache如何利用统一内存池化、通信与计算如何重叠、算子如何针对互联拓扑精准调优……这些过去依赖专家反复试错的调参空间,如今由多Agent在闭环中自动搜索、验证、回滚、再优化,逐轮逼近该模型在当前超节点上的最优配置。
结果是双向的:一方面,超节点的硬件与通信优势被充分释放,模型跑得更快、更稳;另一方面,适配与调优成本被AI自动化大幅压缩,单位算力产出提升、部署周期缩短,最终体现为更优的TCO(总拥有成本)——不是靠堆更多芯片,而是让每一颗芯片、每一条链路都跑到最佳状态。
自主进化:持续自我改进,越用越聪明
软硬协同解决了“单次适配的最优解”,但AI时代的模型迭代是持续的。ModelGenius的另一重价值在于——它不会止步于一次交付,而是一套会“长大”的系统。
依托知识库与技能库的双闭环设计,ModelGenius在每一次适配任务结束后都会自动复盘:成功经验沉淀为可复用的技能(Skill),失败教训清洗为错误知识,新算子登记入库、评测基线持续扩充。平台适配过的模型越多、积累的知识越厚,下一次适配的速度和成功率就越高——这就是典型的规模化自我改进(Recursive Self-Improvement, RSI)路径。
换句话说,它越用越强,做的活越多,就越懂怎么做。同一个平台,第一次适配是新手,第三次已是老手。
具体来看,ModelGenius的闭环分两层:
·执行闭环:覆盖“需求拆解→分派→执行→验证→反馈→沉淀”;验收不通过则定向重派、失败自愈、回滚基线;
·知识闭环:覆盖“执行复盘→经验沉淀(错误表/成功记录)→算子库注册→基线扩充→Skill演进→下轮复用”。
两层闭环叠加,才让“越用越聪明”不是口号,而是可复用的工程机制。对于超节点场景尤其如此:每一次针对高带宽、统一内存访问特性的调优经验,都会沉淀为可复用的技能与基线,让后续模型在超节点上的自适应优化起点更高、收敛更快。
这种沉淀不只发生在单个项目里,也发生在跨平台、跨框架的适配过程中。当前AI算力格局“百花齐放”,但每换一家芯片厂商,模型适配往往要“推倒重来”。ModelGenius给出的答案是逐步沉淀一套持续演进、与芯片厂商深度协作的统一算子与适配知识体系。通过构建基础算子库、融合算子库与跨平台适配知识库,ModelGenius已支持vLLM、SGLang等主流推理框架,并广泛适配主流国产GPU平台。多框架、多平台的深度适配经验持续沉淀,为未来形成“一次沉淀、处处复用”的统一算力适配层奠定基础——这正是高效匹配各GPU厂商芯片、降低国产算力使用门槛的关键路径。
它的目标,是让“任何模型 × 任何芯片”都不再是问题。多智能体协同、算子库持续累积、平台自我进化,最终指向一个画面:国产芯片百花齐放,每一颗都能第一时间跑上最新最强的模型,并且跑出最好的性价比。
对于企业来说,这套系统带来的改变是直接的:
·过去要几个月才能完成的适配,现在可能压缩到几周甚至几天;
·过去高度依赖少数专家,现在更多环节可以由Agent自动完成;
·过去每次适配都是“从零开始”,现在每一次都在为下一次积累经验;
·过去超节点的带宽与内存优势要靠专家手工挖掘,现在由AI自动迭代逼近最优TCO。
全栈开放:共建不绑卡、不绑框架的开放生态
ModelGenius本身就是中兴通讯“全栈开放”理念的生动实践——以开放的接口与解耦的架构,让客户在国产算力生态中拥有充分的自主选择权。
这一开放理念不只体现在软件层,也贯穿硬件层。ModelGenius与OEX超节点一前一后,共同构成中兴面向国产算力生态的“开放组合拳”:
·OEX超节点:打造“算力集装箱”,通过前置式开发,在芯片设计阶段提前开放接口、对接框架,把“芯片上市后再做”的适配前置到上市之前,缩短芯片上市适配周期;
·ModelGenius:通过多Agent协同与知识闭环,把模型迁移从“专家手工”变成“AI自动”,缩短模型迁移时间,让新模型更快跑在国产芯片上。
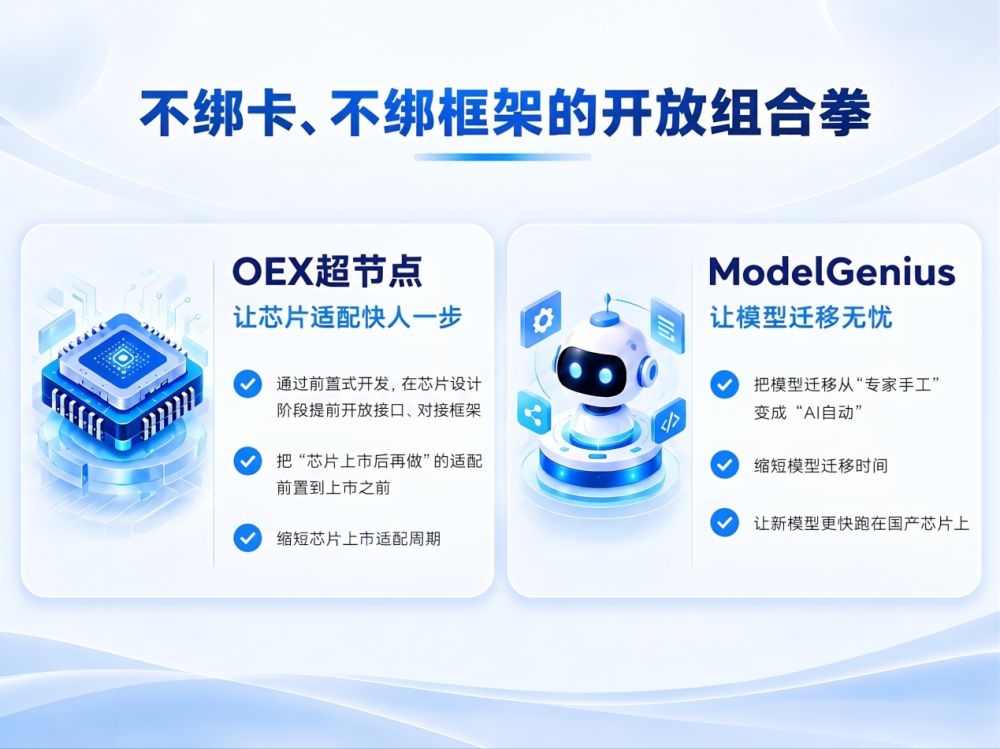
一个解决“芯片到平台”的适配效率,一个解决“模型到芯片”的迁移效率。软硬协同之下,超节点的带宽与内存优势才能进一步转化为可感知的TCO。
更重要的是,这种“硬件前置开放 + 软件自动迁移 + 软硬协同调优”的组合,正是“不绑卡、不绑框架”的底层支撑:芯片侧提前开放,客户不必被单一硬件锁定;模型侧自动迁移,客户不必被单一框架绑定;超节点侧自动调优,客户不必为每一款模型重复支付专家调优成本。国产算力生态由此从“各自为战”走向“统一适配”。
结语:算力竞赛的下半场,拼的是“效率”
说到底,大模型时代拼的不只是模型本身,更是从模型到硬件的“最后一公里”。
这条路上有两个关键瓶颈:芯片侧上市适配周期长,模型侧迁移适配慢。OEX超节点用前置式开放缩短芯片上市适配周期,并用高带宽互联与统一内存访问拉高硬件上限;ModelGenius用多Agent协同缩短模型迁移时间,并针对每个模型做自适应迭代自优化,把硬件上限转化为最佳TCO。一个让芯片更快被用起来,一个让模型更快跑起来、跑得更划算。两者结合,才真正打通了从芯片到模型的完整适配链路。
当AI竞争从“谁有更多芯片”转向“谁能更高效地产出价值”,适配速度与性能上限,正成为分水岭。有人选择追逐更大规模的算力,中兴则选择了一条更难的路——让已有算力释放更大价值。ModelGenius用AI重构适配链路,把“适配"从成本中心,变成了智算生态的加速引擎。
大模型迭代不会减速,国产算力生态也会持续丰富。真正决定AI规模化落地速度的,不只是模型有多强、芯片有多快,而是从芯片到模型之间那条“适配链路”是否足够短、足够自动、足够聪明——以及这条链路,能否把超节点的高带宽与统一内存优势,真正转化为客户可感知的TCO竞争力。