C114讯 9月17日午间消息(蒋均牧)华为全联接大会2026今日在上海隆重揭幕,华为副董事长、轮值董事长汪涛在主论坛上深入浅出地揭示了“为什么必须走超节点之路”。
目前全球万亿级的MoE模型正在快速迭代,各方交替领先,10万卡的算力集群即将成为训练顶尖大模型的标准配置。但一个10万卡集群的有效算力,远小于1.25万个8卡标准服务器的有效算力之和。而模型浮点算力利用率(MFU)的提高是个世界级难题——MFU每提升一个百分点,模型的迭代就可以提前约三天时间,这对日新月异的模型迭代至关重要。
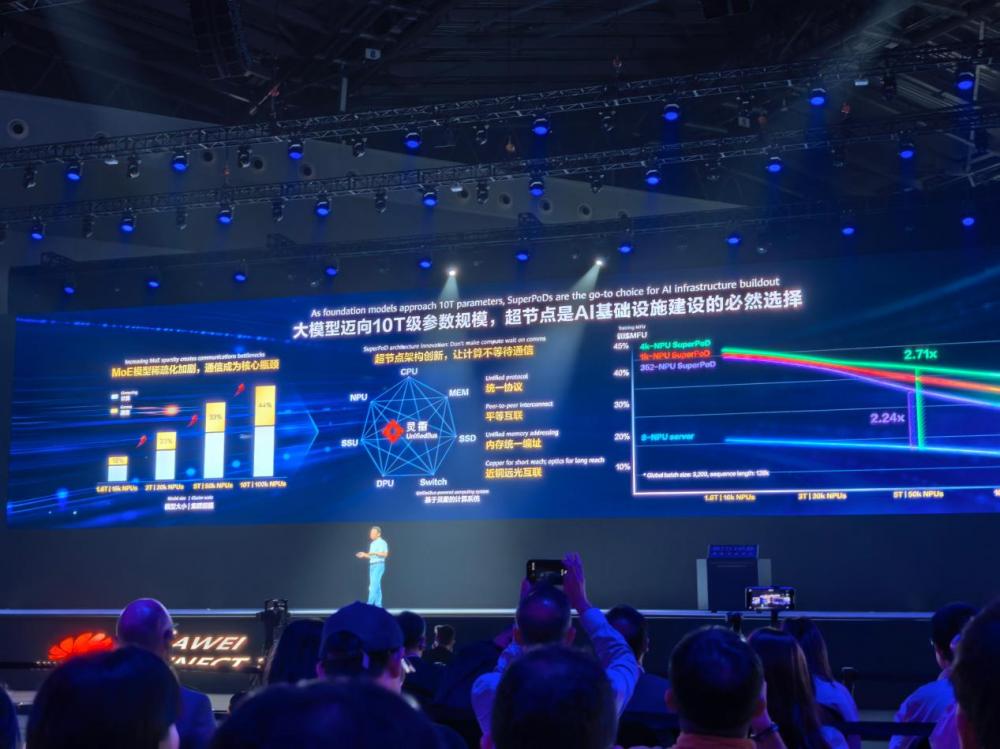
汪涛指出,当前主流的MoE模型在训练过程中,涉及数万乃至数十万颗芯片和数百亿次的通信,来对齐每一层、每一个计算过程的中间结果。经仿真,由8卡服务器组成的10万卡集群在训练过程中,芯片间的通信代价超过了所有训练时间的40%。在传统的计算架构中,服务器之间相比服务器内部会出现数量级的时延增加,一次通信从百纳秒级变成几十微秒。因此,围绕减少通信占比来优化计算系统架构,是构建一套高效率AI基础设施的合理技术选择。
华为超节点的设计理念,是以一套协议平等连接超节点内的所有组件,支持跨物理服务器的统一内存编址,并采用光互联的方式,使数万颗芯片之间的通信有近乎线性的带宽与时延,像一台计算机一样工作,能够有效提升MFU。根据仿真结果,在相同集群规模下,用超节点构建的大规模集群和用普通8卡服务器构建的大规模集群,MFU饱和曲线有比较大的差异:超节点规模越大,收益越明显。
“仿真结果显示,由4k-NPU规模超节点组成的10万卡集群,相比由8卡服务器组成的10万卡集群,MFU提升了2.75倍。基于此,我们可以得出一个结论:超节点是建设超大规模AI基础设施的必然选择。”汪涛谈到。
去年的全联接大会上,华为全面开放灵衢(UnifiedBus)协议的技术规范。围绕该协议,打造了覆盖计算、互联、存储、管理的11颗关键芯片——既有承担核心计算的鲲鹏CPU与昇腾NPU,也有Scale-out平面大容量交换芯片、Scale-up平面低时延交换芯片和高速光互联芯片,还有面向AI KV缓存专门打造的Smart Storage Unit,以实现平等一跳直达的缓存系统。正是这套芯片组合,为更具竞争力的超节点和集群提供了底座。